El trabajo pesado de SAP ocurre mientras todos duermen
Todo administrador Basis lleva grabada en la memoria la misma escena: llegar a la oficina por la mañana y descubrir que la facturación nocturna no terminó, que el MRP no se ejecutó o que el cierre contable quedó a medias. El impacto en el negocio al día siguiente no es menor: pedidos bloqueados, informes erróneos, decisiones tomadas sobre datos incompletos.
La raíz del problema está en la naturaleza invisible de los procesos de fondo de SAP (Background Jobs). A diferencia de las transacciones que un usuario ejecuta en tiempo real, los jobs de background corren en la sombra: de madrugada, en cadena, sin que nadie los supervise activamente. Cuando algo falla, la primera pregunta —¿qué job falló, cuándo, por qué y en qué paso exacto?— puede llevar horas de investigación.
Este artículo explica por qué la transacción SM37, durante décadas el estándar para revisar los procesos de fondo, ha dejado de ser suficiente en entornos de observabilidad modernos, y cómo el nuevo módulo de investigación de Jobs de SPOT Observability 2.0 convierte un proceso de diagnóstico que antes llevaba horas en un análisis de segundos.
El peso operacional de los Background Jobs en un entorno SAP productivo
Los procesos de fondo son la columna vertebral operativa de cualquier implantación SAP de tamaño medio o grande. Aglutinan tareas críticas para el negocio que, por su naturaleza, no pueden ejecutarse con usuarios activos:
La facturación masiva nocturna procesa miles de documentos de venta y genera los apuntes contables correspondientes. El planificador de necesidades de materiales (MRP) calcula las propuestas de compra y fabricación para el día siguiente. El cierre contable periódico consolida saldos y prepara los libros para reporting. Las interfaces con sistemas externos —ERP de clientes, plataformas logísticas, sistemas bancarios— transfieren datos de forma asíncrona a través de jobs programados.
El volumen de jobs activos en un sistema SAP productivo puede superar fácilmente los cientos de ejecuciones diarias. Gestionar ese ecosistema con una herramienta diseñada para la consulta puntual, y no para la observabilidad continua, es una fuente constante de riesgo operacional.
La SM37: una herramienta potente, pero no diseñada para la observabilidad
La transacción SM37 (Selección de trabajos de fondo) ha sido durante décadas la herramienta de referencia para la gestión de Background Jobs en SAP. Permite lanzar, monitorizar, liberar y cancelar jobs, además de consultar su historial de ejecución y leer los logs asociados.
Sin embargo, su diseño responde a una época en la que la observabilidad no era un concepto aplicado a los sistemas de gestión empresarial. Presenta varias limitaciones estructurales que se hacen especialmente evidentes en entornos con alta carga de procesos de fondo:
- Acceso sistema a sistema: para revisar el estado de los jobs en un paisaje con varios sistemas SAP (desarrollo, calidad, preproducción, producción), es necesario entrar en cada uno por separado. No existe una vista consolidada multi-sistema.
- Diagnóstico reactivo: la SM37 muestra el estado de un job, pero correlacionar un fallo con el estado de la infraestructura en ese momento —carga de Work Processes, alertas de sistema activas, presión del servidor— requiere navegar por múltiples transacciones y cruzar datos manualmente.
- Logs embebidos de difícil lectura: el log de un job complejo, especialmente cuando ejecuta varios pasos y programas ABAP, puede contener cientos de líneas. Identificar el mensaje de error relevante entre el ruido requiere experiencia y tiempo.
- Sin alertas proactivas integradas: la SM37 no envía notificaciones cuando un job falla o supera su duración habitual. El equipo solo se entera del problema cuando alguien consulta activamente la transacción o cuando el error ya tiene consecuencias en el negocio.
SPOT Observability 1.0: el primer paso hacia la visibilidad de Jobs
En la primera versión de SPOT Observability, el equipo de producto abordó este problema con indicadores globales de estado: los llamados Job Outcomes. Esta capa inicial permitía al equipo Basis saber, de un vistazo, cuántos jobs habían fallado, cuántos habían sido cancelados y cuáles llevaban más tiempo del esperado en ejecución (Long-running jobs).
Era un avance significativo respecto a depender exclusivamente de la SM37, porque ofrecía una alerta temprana: el administrador sabía que había un problema antes de que el negocio lo notara. Sin embargo, la información disponible se limitaba al síntoma. Saber que tres jobs habían fallado era útil; saber exactamente cuál, en qué paso, con qué error y bajo qué condiciones de infraestructura era todavía una investigación aparte.
SPOT Observability 2.0: el módulo de Investigación de Ejecución de Jobs
La versión 2.0 de SPOT Observability incorpora un módulo completo de investigación de Jobs de SAP que cierra la brecha entre saber que hay un problema y entender exactamente qué lo causó. El resultado es lo que el equipo de producto llama la caja negra de los Background Jobs, ahora abierta y legible desde un panel centralizado, sin necesidad de acceder al SAP GUI.
El módulo se articula en cinco bloques funcionales que cubren desde la visión macro del estado de la infraestructura hasta el detalle milimétrico del log de cada ejecución:
1. Control Macro: Job Monitoring en tiempo real
El primer bloque ofrece una visión de altitud sobre la presión que los procesos de fondo ejercen sobre la infraestructura SAP. Visualiza los picos de ejecución por servidor, la distribución de jobs activos entre los distintos hosts y el estado agregado de los Job Outcomes en tiempo real.
Este nivel de visión es especialmente útil para detectar situaciones de saturación: momentos en los que demasiados jobs compiten por los mismos recursos de Work Process o de base de datos, lo que puede provocar cuellos de botella que afectan tanto a los procesos de fondo como a los usuarios en línea.
2. Job Execution Ledger: el libro mayor de los procesos de fondo
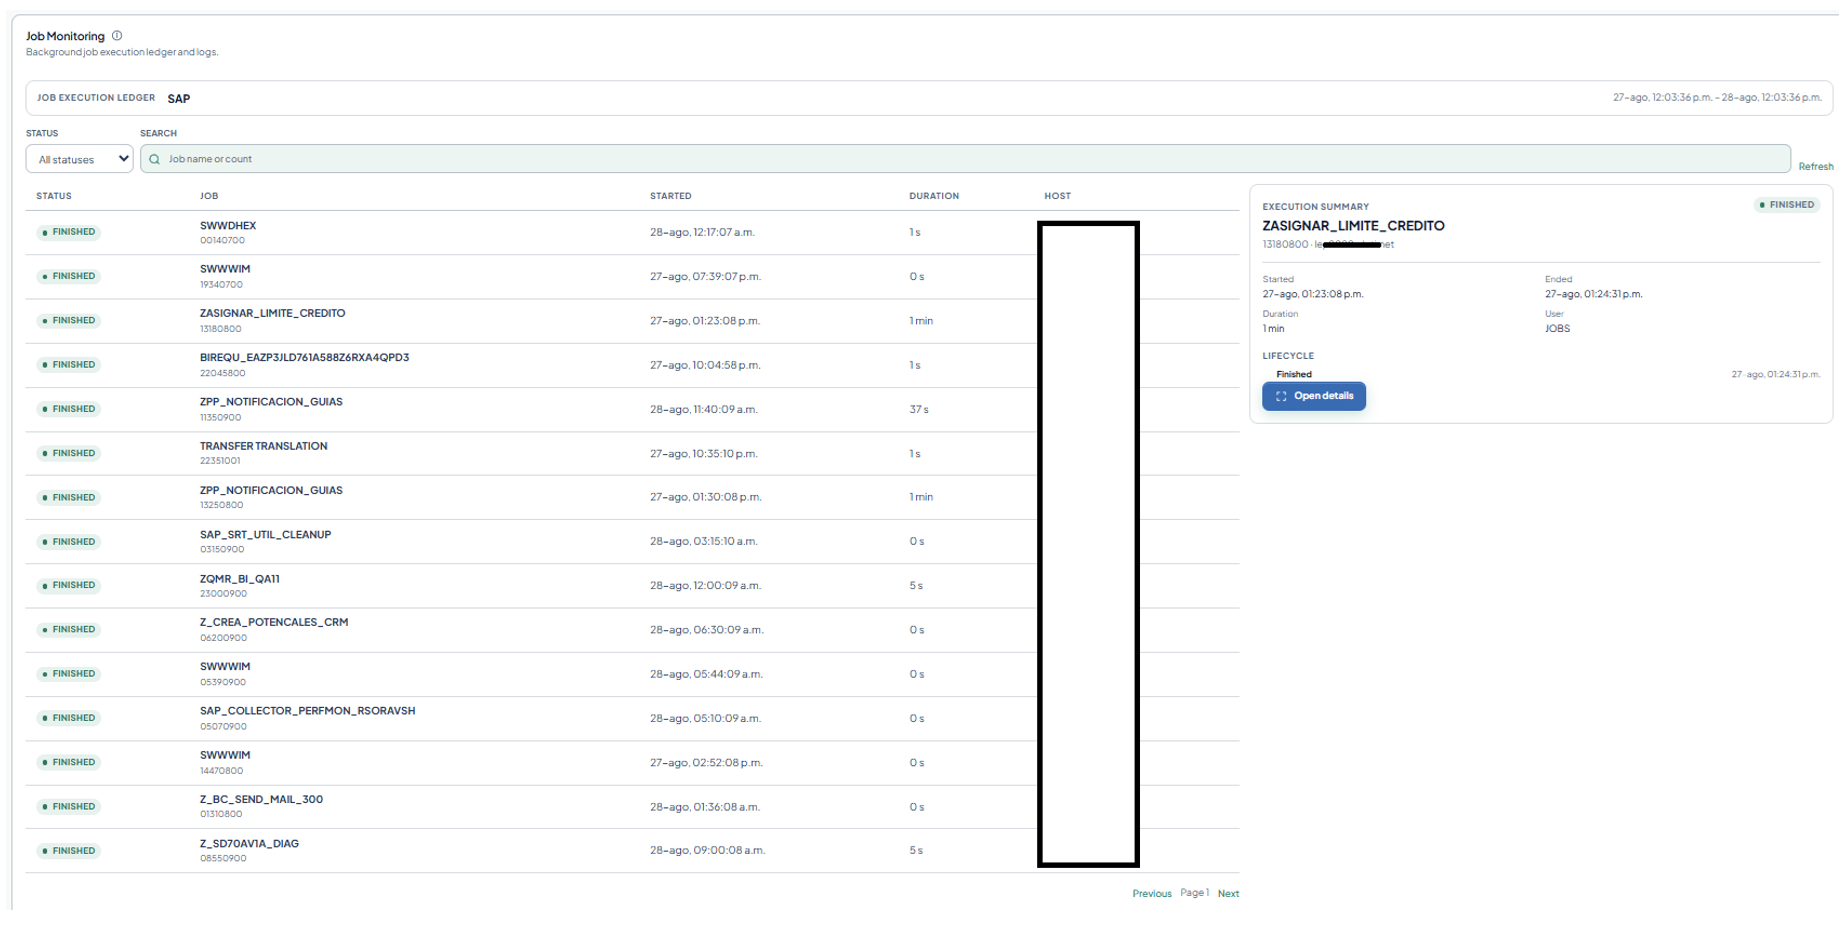
El segundo bloque es el inventario completo de todas las ejecuciones de jobs del sistema. Funciona como un libro mayor interactivo y filtrable que recoge el historial de procesos de fondo con sus metadatos principales: nombre del job, estado de ejecución, duración, host asignado y marcas de tiempo de inicio y fin.
La capacidad de filtrado y búsqueda del Ledger permite localizar rápidamente cualquier ejecución histórica: por nombre de job, por rango horario, por servidor o por estado. En un entorno con cientos de ejecuciones diarias, esto elimina la necesidad de hacer scroll por listas interminables o construir variantes de selección complejas en la SM37.
3. Execution Summary: la radiografía de cada job
Hacer clic sobre cualquier job del Ledger abre su Execution Summary, la ficha completa de esa ejecución concreta. En ella se recoge quién lanzó el job (usuario ejecutor), la hora exacta de inicio y fin, el ciclo de vida completo del proceso y el estado final de cada paso de la cadena.
Por ejemplo, un job crítico como ZASIGNAR_LIMITE_CREDITO —que procesa las propuestas de crédito pendientes de validación en el módulo de ventas— puede tener un historial de ejecución diaria. El Execution Summary permite ver, para cada instancia de ese job, si terminó correctamente, si hubo pasos con warning y exactamente cuánto tardó en completarse respecto a su media histórica.
4. Extracción Nativa del Job Log: el análisis forense completo
Esta es la funcionalidad más destacada del módulo. SPOT Observability 2.0 extrae el log completo del job directamente al panel, paso a paso y sin necesidad de acceder al SAP GUI.
El log extraído incluye todos los mensajes generados durante la ejecución: los programas ABAP exactos que se ejecutaron en cada paso (por ejemplo, ZSD_ASIG_LCREDITO), las variantes utilizadas para parametrizar la ejecución (como /AFECTADOSGC), los mensajes de sistema con su nivel de severidad, y los códigos de error asociados a cada evento (por ejemplo, el código 00/516).
La diferencia respecto al flujo tradicional es sustancial. En el proceso habitual, llegar a este nivel de detalle requería entrar en la SM37, localizar el job, abrir el log, navegar entre los pasos y, a menudo, consultar también la SM21 o la ST22 para cruzar la información. Con la extracción nativa de SPOT 2.0, toda esta información está disponible en el mismo panel, en segundos.
5. Job Events: correlación con la infraestructura SAP
El quinto bloque cierra el ciclo de análisis con un registro centralizado de alertas CCMS y eventos del dominio de background. Esto permite correlacionar los fallos en la ejecución de jobs con eventos más amplios de la infraestructura: alertas de base de datos, saturación de Work Processes, errores de comunicación o reinicio de instancias.
La correlación temporal es clave para distinguir entre un fallo puntual de un job —provocado por un error en los datos de entrada o en la lógica ABAP— y un fallo sistémico provocado por una condición de la infraestructura que afectó a múltiples procesos simultáneamente.
Un flujo de diagnóstico completo: de la alerta al log en una sola sesión
La forma más clara de entender el valor del módulo es seguir el flujo de diagnóstico que un administrador Basis seguiría ante un fallo nocturno.
Escenario: a las 7:00 de la mañana, el equipo recibe una alerta: varios jobs del batch nocturno han fallado. En el modelo tradicional, el proceso de investigación implica abrir la SM37, definir una variante de selección para el rango horario, revisar los jobs con estado de error, abrir cada uno, leer el log y, si el error no es evidente, cruzar con la SM21 para ver si hubo eventos de sistema relevantes en ese mismo momento. Este proceso puede llevar entre 20 minutos y varias horas dependiendo de la complejidad.
Con SPOT Observability 2.0, el flujo es completamente distinto. La alerta llega directamente al panel. El Job Monitoring muestra si hubo presión anómala sobre la infraestructura en la ventana horaria del fallo. El Job Execution Ledger lista todas las ejecuciones fallidas con un clic de filtro. El Execution Summary de cada job afectado muestra el paso exacto en el que se detuvo. La extracción nativa del log proporciona los mensajes, programas y códigos de error sin salir del panel. Y Job Events añade el contexto de infraestructura: si hubo una alerta de base de datos, una saturación de Work Processes o un evento de sistema que explique el fallo encadenado.
El resultado es que el diagnóstico que antes requería múltiples transacciones y herramientas separadas se convierte en una investigación lineal dentro de un único panel, accesible desde cualquier navegador.
Del diagnóstico reactivo a la observabilidad operacional
La SM37 no desaparece de SAP, pero en un entorno donde la disponibilidad de los procesos de fondo es tan crítica como la de cualquier servicio de cara al usuario, depender de una herramienta de consulta manual no es suficiente.
El módulo de investigación de Jobs de SPOT Observability 2.0 no solo resuelve el problema de visibilidad; cambia el modelo mental del equipo Basis: de reaccionar a fallos que ya tienen consecuencias en el negocio, a operar con un nivel de información que permite diagnosticar, entender y actuar antes de que el impacto llegue a los usuarios.
Descubre todas las novedades de SPOT Observability 2.0 en www.spotobservability.com